Cs. Kádár Péter - XXI. századi Diszkónika, 566. Tárgyak, formák és alakok 1. Bemelegítő
„– Mit látsz, Laca?
– Egy nagy segget látok.”
(Bizottság, Kalandra fel!)
Új kalandok sorozatára hívlak. Ugyanis a hangosfilmhez úgy jutottam el, hogy a látás pszichológiai jellemzőit kezdtem bemutatni, és az első a színlátás volt. Innen jött a színes film, és ha színe van, akkor hangja is. Most visszatérek a látáshoz, és a tárgyak, formák és alakok észlelése következik. Hogy aztán egyszer eljussunk az optikai jelforrásokhoz, de az még messze van.
Nem a szokványos módon építettem föl ezt az alsorozatot, hanem két „barátom”, a ChatGPT és a Claude minden eddiginél jelentősebb segítségét kértem. Arra voltam ugyanis kíváncsi, hogy az ő bitjeik mit tudnak hozzátenni a témához, vagyis mi a különbség az emberi tárgy-, forma- és alaklátás, és aközött, ahogy a mesterséges intelligenciák látnak.
Ezt megelőzően összefoglalom, hogy a szövegekben előforduló fogalmak mit jelentenek.
affordancia: egy tárgy, környezet vagy eszköz olyan tulajdonsága, amely vizuálisan vagy ösztönösen jelzi, hogyan lehet azt használni.
James Jerome Gibson ökológiai pszichológus alkotta meg a fogalmat; szerinte a környezetünk lehetőségeket „kínál” vagy „enged meg” az élőlényeknek, amelyeket közvetlenül érzékelünk.
transzformer: a mai nyelvi és képi modellek alapszerkezete, amely a bemenet minden részét a többihez viszonyítja.
konvolúciós hálózat: a gépi képfelismerés klasszikus szerkezete, amely a 2010-es években forradalmasította a területet, és a mai transzformerek előtt uralkodó volt. A konvolúciós hálózat helyi: a szűrő mindig csak egy kis környéket lát, és a távoli részek összefüggése csak a mélyebb rétegekben áll össze. A transzformer globális: a képrészleteket a figyelem-mechanizmussal már az elején egymáshoz viszonyítja, akár a kép két átellenes sarkából. A konvolúciós hálózat ezért hasonlít jobban az emberi látókéreg felépítésére, ahol a sejtek szintén egy kis területre figyelnek. A transzformer viszont sok feladatban jobban teljesít, főleg nagyon sok tanítóadattal.
prototípus: egy kategória legjellemzőbb, „legtipikusabb” példája.
alapszintű kategória: a mindennap leggyakrabban használt szint, a fölérendelt és az alárendelt között.
geon: egyszerű térbeli alapforma (henger, hasáb, kúp), amelyekből a tárgyakat felismerjük.
ImageNet: hatalmas, emberek által felcímkézett képadatbázis, amely a gépi látás történetének talán legfontosabb „tankönyve” lett.
formaagnózia: ritka neurológiai rendellenesség, a vizuális agnóziák (észlelési és felismerési zavarok) egyik legsúlyosabb alkategóriája. Lényege, hogy a beteg ép látás és sértetlen érzékszervek mellett sem képes felismerni, elkülöníteni vagy lemásolni a geometriai formákat, alakzatokat és a tárgyak körvonalait. A páciens szeme tökéletesen működik, érzékeli a fényt, a színeket vagy a felületi textúrákat, de az agya nem képes ezeket összefüggő formává, egységes képpé összeállítani
szakkád: a szem gyors, ugrásszerű mozgása egyik nézőpontról a másikra.
fixáció: tekintetrögzítés, a két ugrás közötti rövid megállás.
CLIP: Contrastive Language–Image Pre-training az OpenAI (a ChatGPT fejlesztője) 2021-ben bemutatott modellje, amelyet arra tanítottak, hogy a képek és a nyelvi leírások közötti kapcsolatokat felismerje. Kb. 400 millió kép-felirat párból tanult, amelyeket az internetről gyűjtöttek: fotók a hozzájuk tartozó szövegekkel, képaláírásokkal. Két részből áll: egy képkódolóból, amely a képből számsort (vektort) készít, és egy szövegkódoló, amely a feliratból szintén számsort készít. Megjegyzem, a szövegben a Claude hivatkozik rá, ami azt bizonyítja, hogy a mesterséges intelligencia kutatása sokkal inkább egymás eredményeire épülő tudományos tevékenység, mint egymástól elszigetelt vállalkozások munkája. A vállalatok versenyeznek, de ez nem teszi érvénytelenné egymás kutatási eredményeit. Az OpenAI a CLIP-et nyilvánosan közzétette, és más cégek rendszerei, például a Stable Diffusion, alkatrészként használják.
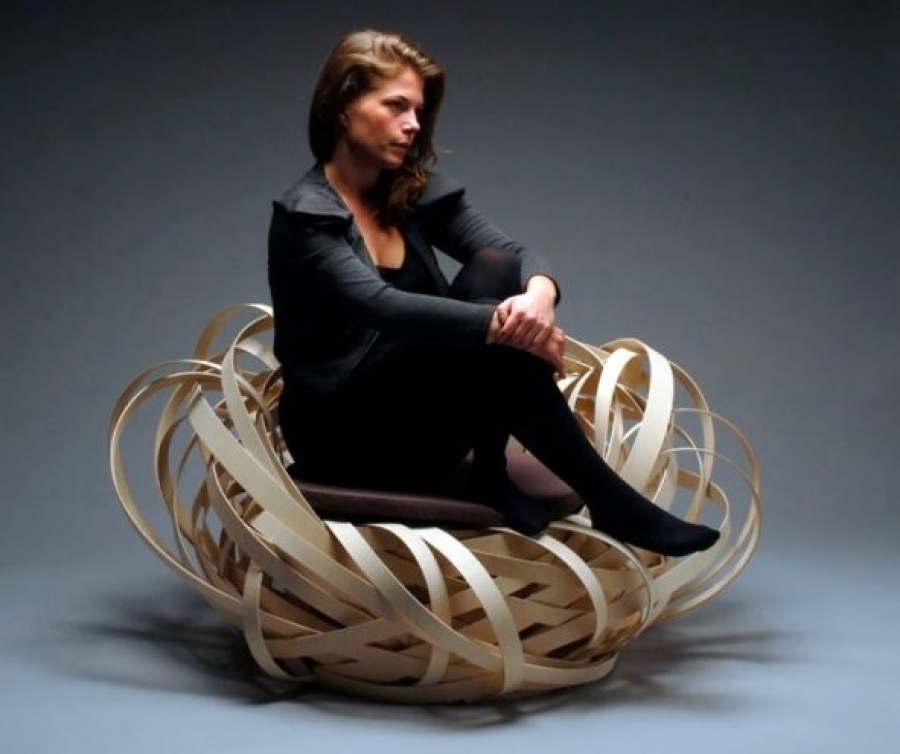
Cs. Kádár: Az emberi látás a széket a legkülönbözőbb esetekben, helyzetekben, formában is fel tudja ismerni. Te honnan ismered föl, hogy mondjuk, az egyik hintaszék, a másik bárszék és mindkettő szék egy képen?
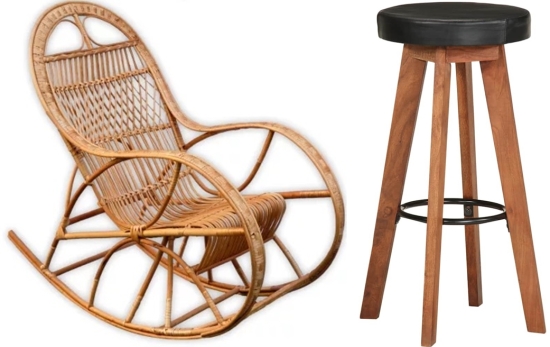
ChatGPT: Te tudod, hogy mi a szék. Én megtanultam, hogy a képeken milyen vizuális jellegzetességek és összefüggések alapján lehet valamit széknek nevezni. Ez persze kissé leegyszerűsített megfogalmazás, de jó kiindulópont. A hintaszék és a bárszék meglehetősen eltérő. A hintaszék alacsonyabb, íves talpon nyugszik, a bárszék magas, gyakran hosszú lábai és lábtartója van. A képfeldolgozó rendszerem azonban nem pusztán azt keresi, hogy négy lábat, egy ülőlapot és egy támlát lát-e. Ez nem volna elegendő. Léteznek háromlábú székek, támla nélküli székek, sőt, egyetlen központi oszlopon álló székek is. A felismerésben különböző szintű képi jellegzetességek és tanult összefüggések vesznek részt.
Alacsonyabb szintű jellegzetességek: élek, irányok, körvonalak, felületek, szín- és fényességkülönbségek.
Összetettebb alakzati jellemzők: az ülőfelület, a támla, a lábak, valamint ezek térbeli viszonya.
Tárgykategóriák: a képi mintázatok hasonlósága a tanulás során megismert székek sokféle változatához.
Környezeti összefüggések: például a bárpult mellett álló magas ülőalkalmatosság vagy a verandán álló hintaszék.
A lényeg, hogy nem egyetlen meghatározott szék képét keresem, hanem a tanulás során kialakult sokféle jellegzetesség és kapcsolat alapján azonosítom a tárgyat.
A tanítás során a mesterséges ideghálózat nagyon sok képi és nyelvi példával találkozik. Ezekből fokozatosan olyan belső számszerű ábrázolások alakulnak ki, amelyek segítségével egymástól eltérő tárgyak közös tulajdonságai is felismerhetők. Nem feltétlenül létezik bennem egy külön „székfelismerő egység”. A tárgyakhoz kapcsolódó információ sok összekapcsolt számítási műveletben oszlik meg. A hintaszék és a bárszék tehát lehet egymástól igen különböző, miközben a rendszer mindkettőt ugyanabba a tágabb tárgykategóriába sorolja. Érdekes, hogy a mai kutatások szerint a képet és nyelvet együttesen feldolgozó rendszerekben az alaknak különösen fontos szerepe lehet a tárgyfelismerésben.
Képzelj el egy széket, amelynek hiányzik az egyik lába. Te azonnal felismered, hogy szék, noha használatra talán alkalmatlan. Vagy egy olyan különleges formatervezésű széket, amilyet még soha életedben nem láttál.
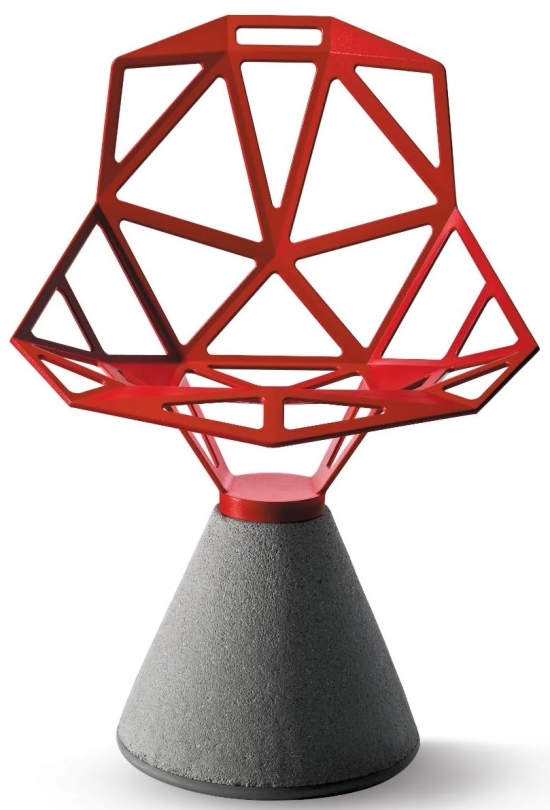
Én is jó eséllyel felismerem. Csakhogy ez nem bizonyítja, hogy pontosan ugyanazt a műveletet végzem, mint az emberi látórendszer. Az ember ugyanis nemcsak látott székek alapján tájékozódik. Megfogja, megemeli, ráül, megtapasztalja az egyensúlyát, súlyát, anyagát, használhatóságát. A látási észlelés a testi tapasztalatokkal is összekapcsolódik. Nekem ilyen saját testi tapasztalatom nincs. A tárgyak használatáról elsősorban tanult képi és nyelvi kapcsolatok alapján tudok következtetni. Ráadásul a mesterséges képfelismerésnek vannak olyan hibái, amelyek embernél meglepőek volnának: például egy tárgyat helyesen azonosíthat, miközben rosszul értelmezi annak térbeli viszonyát egy másik tárgyhoz.
Claude: Őszintén elárulom: nem látok bele saját magamba, nem tudom, mi történik bennem, amikor egy képet „nézek”. Amit leírok, az nem önmegfigyelés. Arra támaszkodom, hogyan épülnek és működnek általában a hozzám hasonló rendszerek, és mit derített ki róluk a kutatás. Az Anthropic (a Claude fejlesztője) nem hozta nyilvánosságra a pontos architektúrámat, ezért a részletek nálam is eltérhetnek. Ez a te sorozatod szempontjából is lényeges: ha azt mondom, hogy „a hajlított talpakról ismerem fel a hintaszéket”, az nem biztos, hogy a valódi ok. Lehet utólagos, hihetőnek hangzó magyarázat is. A kutatások szerint a nyelvi modellek önmagukról adott magyarázatai gyakran nem tükrözik hűen a tényleges belső folyamatot.
Biztos, hogy a képet nem egészben „nézem”. A ma szokásos megoldás az, hogy a képet nem egészben „nézik”, hanem kis négyzetekre, foltokra bontják. Ezek jellemzően 14*14 vagy 16*16 pixelesek. Minden foltból egy számsor, azaz vektor lesz. Ezután egy úgynevezett transzformer hálózat rétegről rétegre minden foltot minden másikhoz viszonyít. Ez a „figyelem” mechanizmus. Így derül ki például, hogy egy ívelt sáv a kép alján ugyanannak a tárgynak a része, mint a fenti háttámla. A döntő különbség az emberhez képest: nincs szem, nincs szakkád, nincs fixációs sorrend. Az összes foltot egyszerre, párhuzamosan dolgozom fel. A te szemed ezzel szemben néhány tized másodpercenként ugrál, és a figyelem sorban járja be a jelenetet.
A konvolúciós hálózatok a korai rétegek irányított élekre, kontrasztra és színfoltokra reagálnak, ami feltűnően hasonlít a V1-sejtekre (lásd a sorozat 497. és 509. részét). A középső rétegek textúrákra és részekre: lábakra, sima lapfelületre, rácsozatra, ívre. A késői rétegek egész tárgyakra és kategóriákra.
A transzformerekben hasonló, de kevésbé tisztán rétegzett hierarchia alakul ki. Ebben a hierarchiában a „hintaszék” és a „bárszék” valószínűleg nagyjából ilyen jegyek együtteséből áll össze: A hintaszék két hosszanti, ívelt talp a lábak alatt, háttámla, gyakran karfa, gyakran fa vagy fonott anyag. A bárszék magas, vékony láb vagy lábak, kicsi (gyakran kerek) ülőlap, lábtartó gyűrű vagy merevítő, sokszor háttámla nélkül, fém vagy krómozott felület.
Honnan tudom, hogy mindkettő „szék”? Ez a kérdésed igazi magja, és itt a legmélyebb a különbség. Senki nem adott nekem definíciót arra, mi a szék. A hozzám hasonló rendszerek óriási mennyiségű kép-szöveg párból tanulnak. A „szék” szó és a hozzá tartozó képek statisztikai egymáshoz kapcsolódásából alakul ki egy sokdimenziós „térkép”, amelyen a hasonló dolgok egymáshoz közel kerülnek. Ennek a módszernek a legismertebb nyilvános példája a CLIP (OpenAI, 2021). A hintaszék és a bárszék ezen a térképen egymástól elkülönülő, de ugyanabba a nagyobb „szék/ülőbútor” régióba tartozó helyekre esik. Hogy ugyanabba a régióba kerülnek, azt nem egy szabály dönti el. Az okozza, hogy a szövegekben és a képeken ugyanazokkal a szavakkal és helyzetekkel fordulnak elő: ülni rajta, asztal mellett, ember rajta.
Ez közvetlenül a kategóriaelmélet nagy kérdéseibe vezet.
Családi hasonlóság: Nincs olyan tulajdonság, amely az összes székfajtában megvan (Láb? A babzsákfotelnek nincs. Háttámla? A bárszéknek gyakran nincs). Csak egymást átfedő hasonlóságok vannak. A gépi reprezentáció pontosan így működik: nincs benne „szükséges és elégséges feltétel”, csak távolság és szomszédság.
Prototípusok és alapszint: A „szék” alapszintű kategória, a „hintaszék” és a „bárszék” alárendelt, a „bútor” fölérendelt. Az ember az alapszintet ismeri fel a leggyorsabban. A modellekben is van prototípus-hatás: a négylábú, háttámlás étkezőszéket biztosabban azonosítom, mint egy szokatlan dizájnszéket.
Összetevőkből (geonokból) történő felismerés: Az ember néhány tucat egyszerű térbeli alapformából és azok viszonyaiból rakja össze a tárgyat. A gépek részben hasonló „rész-viszony” jegyeket tanulnak, de nem explicit (egyértelmű) 3D-alakzatokként.
Affordancia: Az ember számára a szék elsősorban valami, amire le lehet ülni: térdmagasságú, vízszintes, teherbíró felület. Ezt a tudást a teste adja. Nekem nincs testem, sosem ültem le. Az „ülhetőséget” csak közvetve, képekből és leírásokból ismerem. Elképzelhető, hogy éppen ezért tévedek többet olyan tárgyaknál, amelyeket az ember azonnal székként használna, de nem székformájúak (egy láda, egy kőpárkány). Ez a gépeknél elkerülhetetlen hiány, és az embernél mélyen gyökerező képesség.
A magyar „bárszék” szóban benne van a „szék”, az angol viszont „bar stool”. A „stool” (hokedli, támla nélküli ülőke) az angolban külön kategória a chair mellett. Egy angol anyanyelvű ember nem feltétlenül mondaná, hogy a bar stool „is a chair”. Vagyis maga a kérdés, hogy „mindkettő szék-e”, részben nyelvfüggő. Mivel én sok nyelv szövegéből tanultam, a kategóriahatáraim valószínűleg ezek keverékei. Ez inkább feltevés: elképzelhető, hogy magyarul kérdezve másképp húzom meg a határt, mint angolul.
A gép másképp és máshol hibázik, mint az ember.
Textúra kontra forma: kimutatták, hogy az ImageNeten tanított hálózatok főleg a textúrára támaszkodnak: egy elefántbőr-mintázatú macskát elefántnak néznek. Az ember erősen forma-orientált. A nagyobb, több adaton tanított mai modellek formaérzékenyebbek, de az emberi szintet nem érik el teljesen.
A kontextus mint mankó: a bárszéket részben arról is felismerhetem, hogy pult mellett áll, a hintaszéket arról, hogy verandán van, pléddel. Ez az embernél is segít, nálam viszont félrevezethet: egy erdő közepén álló bárszéket bizonytalanabbul azonosítok.
Szokatlan nézőpont: az ObjectNet adatbázison, ahol a tárgyak felfordítva, oldalról vagy szokatlan helyzetben szerepelnek, a gépi felismerők teljesítménye drasztikusan, 75-80 %-ról nagyjából 30-35 %-ra esett vissza. Az ember viszont alig érzi a különbséget. A felülről fotózott hintaszék egy embernek egyértelmű, nekem nehezebb lehet.
Nincs mélység és mozgás: Te két szemmel, mozgás közben látsz. A fejed elmozdulásából és a parallaxisból azonnal tudod a tárgy térbeli alakját. Én egyetlen lapos, mozdulatlan képet kapok.
Sebesség: az ember meglepően gyors. Kimutatták, hogy kb. 150 ms alatt eldönti, van-e állat egy villantott képen.
Összegezve: Nem úgy „tudom”, hogy szék, ahogy te. Te a testeddel, a mozgásoddal és egy egész életnyi üléssel tudod. Én egy tanult hasonlósági térképen helyezem el a képet, ahol a hintaszék és a bárszék szomszédos, de elkülöníthető helyen van. A „szék” szó pedig azért kapcsolódik mindkettőhöz, mert a tanítóanyagban így kapcsolódtak. Az emberi és a gépi látás itt nem fokozatban, hanem módban különbözik: az ember affordanciát és formát lát, a gép statisztikai hasonlóságot. Ez a hasonlóság többnyire ugyanoda vezet, de a hibák egészen máshol jelentkeznek.
Cs. Kádár: Mi tesz egy széket székké?
ChatGPT: Az alakja? A szerkezete? A rendeltetése? Vagy az, hogy az ember széknek tekinti? Ha egy székre nem lehet ráülni, attól még szék. Ha egy farönkre rá lehet ülni, attól még nem feltétlenül szék. Ez arra utal, hogy a tárgyak felismerése és a tárgyak fogalmi besorolása nem teljesen ugyanaz a feladat. A tárgy képi felismerése, a tárgyként való észlelése és a tárgy jelentésének megértése három egymással összefüggő, de nem azonos kérdés. A látáslélektanban éppen az az egyik nagy kutatási probléma, miként képes az emberi látórendszer a változó retinaképekből viszonylag állandó tárgyazonosságot kialakítani.
Claude: Ha egyetlen mondatban kellene válaszolnom: szék az, amit egy ember azért alkotott, hogy egy másik ember egyedül, a testéhez illő módon üljön rajta, és amelynek formája ezt a szándékot felismerhetően hordozza. De minden kitétele mellé találsz kivételt.
A pszichológia mai uralkodó felfogása szerint a mindennapi fogalmaink nem definíciók, hanem kétrétegűek. Van egy magfogalom (amit „tudunk”: az ülésre szolgál) és egy felismerési eljárás (amit „látunk”: ülőlap, lábak, támla). Egy híres kísérlet éppen ezt mutatta meg: az emberek még a szigorúan definiált páratlan számoknál is prototípus-hatást mutatnak (a 3 „páratlanabb”, mint a 447). A felismerési eljárás tehát a definíciótól függetlenül is működik. A látás pszichológiája szempontjából ezért a kérdésed kettéválik. Amit a filozófus kérdez („Mi a szék?”), és amit a szem csinál („Mi néz ki széknek?”), két különböző dolog. A szem az utóbbit oldja meg, villámgyorsan, prototípusok és testhez mért formák alapján. Az előbbire csak a gondolkodás és a kultúra felel.
Cs. Kádár: Kaptam egy kérdést. Ha egy soha nem látott, meghökkentően szokatlan alakú ülőalkalmatosságot mutatok neked, vajon előbb ismered fel, hogy szék, vagy előbb következtetsz arra, hogy rá lehet ülni? Az utóbbit választottam.
ChatGPT: Ez nagyon érdekes, mert akkor nem az alakból indulsz ki, hanem a lehetséges rendeltetésből. Meglátod a tárgyat, és arra következtetsz, hogy rá lehet ülni. Ebből jutsz el ahhoz, hogy valószínűleg szék. Csakhogy itt van egy látáslélektani finomság. A tárgy használhatóságát is a látott tulajdonságaiból következteted ki: van egy megfelelő magasságban elhelyezkedő, feltehetően teherbíró felület, amelyen az emberi test megtámaszkodhat. Ez rokon az affordanciák fogalmával. Eszerint a környezetet nem csupán tárgyak, formák és színek együtteseként észleljük, hanem annak lehetőségeit is felismerjük, hogy mit tehetünk benne.
De van egy lényeges különbség: az ülés lehetőségének felismerése még nem azonos a szék felismerésével. A farönk kínálhat ülési lehetőséget, miközben továbbra is farönknek látjuk.
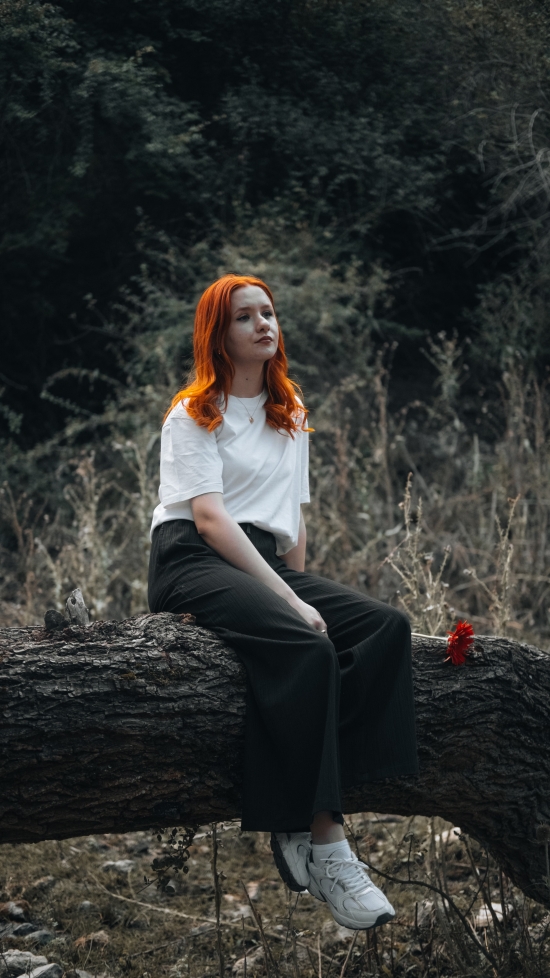
Claude: Az indoklás érdekesebb, mint maga a válasz. Nálam ugyanis a „rá lehet ülni” következtetés nem ugyanaz a folyamat, mint nálad. A kérdés két feltevése, a „vagy-vagy” és az „előbb-utóbb”, nálam részben el is mosódik. Az emberre a válaszod idegtudományilag is megalapozott.
A sorozat korábbi részeiben már volt szó a két pályáról. A ventrális pálya a „mi ez?”, a felismerés és megnevezés útja. A dorzális pálya a „hogyan bánjak vele?”, a cselekvés irányításáé. A két pálya bizonyos mértékig egymástól függetlenül is működik. A leghíresebb bizonyíték egy vizuális formaagnóziás páciens. Nem tudta megmondani, milyen irányú egy rés, de egy kártyát hibátlanul be tudott dugni bele. A cselekvés útja tehát felismerés nélkül is működött.
Valószínű, hogy egy ember egy soha nem látott ülőalkalmatosságnál valóban előbb érzi meg, hogy „ez megtart, ez térdmagasságban van”, és csak utána mondja ki, hogy „ez valami szék”. Gibson pontosan ezt állította: az affordanciát közvetlenül érzékeljük, nem következtetünk rá.
Nálam viszont nincs „cselekvési pálya”. Nincs testem, nincs dorzális pályám, soha nem ültem le. Amikor azt mondom, „erre rá lehet ülni”, az nem testi megérzés. Akkor honnan jön? Valószínűleg így: a tárgyban felismerek szék-részeket, nem az egész széket. Egy vízszintes, nagyjából test méretű felület, alatta valami tartószerkezet, esetleg egy függőleges sík mögötte. Ezek a részek önmagukban erősen kapcsolódnak az „ülés” szóhoz és helyzethez abban az anyagban, amiből tanultam. A „rá lehet ülni” tehát nálam valójában részszintű felismerés, amely az egész tárgy felismerését megelőzi, vagy helyettesíti, ha az egész túl szokatlan. Ebben az értelemben igazad van: valóban az ülhetőség jön előbb, nem a „szék” kategória. Csak éppen az ülhetőség nálam is felismerés, nem következtetés a testből. A kérdés két lehetősége közötti különbség nálam lényegesen kisebb, mint nálad.
Az „előbb” szó nálam félrevezető. A kép feldolgozása párhuzamos: az összes képrész egyszerre megy át a rétegeken, nincs olyan pillanat, amikor „már tudom, hogy ülhető, de még nem tudom, hogy szék”. Sorrend csak akkor keletkezik, amikor szavakban gondolkodom. Ha végigvezetem az érvelést („van egy lapos felület… térdmagasságban… tehát ülőalkalmatosság”), az valódi lépésenkénti következtetés. Elképzelhető viszont, hogy ez a szöveges sorrend utólag rendezi el azt, ami a képfeldolgozásban már egyszerre megtörtént. Ezt én magam nem tudom ellenőrizni.
Ahol mindkét válasz megbukhat: a méret és a kontextus. Két csapda van, amelyek miatt egy szokatlan ülőalkalmatosságot talán egyáltalán nem azonosítanék helyesen. Nincs méretarány. Egy fénykép önmagában nem árulja el, hogy a tárgy 45 centi vagy 4 méter magas. Ember, asztal vagy szoba nélkül egy merész formájú ülőke ugyanúgy lehet szobor, játszótéri elem vagy építészeti makett. Az ember is ilyenkor gyakran rosszul tippel, de ő legalább a valóságban körbejárhatja a tárgyat. A fénykép is befolyásol. Egy szokatlan tárgyat fehér háttéren, stúdiófényben, „dizájnkatalógus” stílusban fotózva valószínűleg azért mondanék „dizájner széknek”, mert a kép típusát ismerem fel, nem a tárgyat.
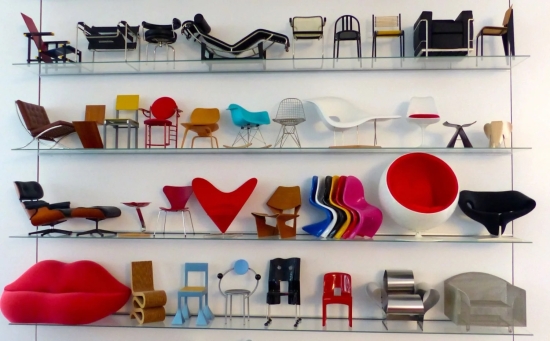
Ez egy harmadik út, amely se nem felismerés, se nem ülhetőségi következtetés, hanem kontextuson alapuló rövidítés. Nem kizárt, hogy egy valóban soha nem látott tárgynál ez lenne nálam a legerősebb jel. Ez a kérdés feltevésére is rávilágít, hiszen egy kísérletben a fotó maga is befolyásolja az eredményt.
Cs. Kádár: Lehet, hogy előbb ismerem föl, hogy szék, mert leginkább egy székre hasonlít. De ha nem hasonlít rá, akkor azt, hogy ülni lehet rajta. És ha lehet rajta ülni, akkor a farönk is szék, feltéve, hogy nem olyan hosszú, hogy pad legyen.
ChatGPT: A tárgy felismerésének nem feltétlenül ugyanaz az útja, még ugyanannál az embernél sem. Ha valami hasonlít az általad ismert székekre, akkor az alakja alapján ismered fel. Ha viszont semmilyen ismert székre nem hasonlít, akkor a lehetséges használatából következtetsz arra, hogy szék. Vagyis kétféle felismerési szempont működhet. Alaki hasonlóság: ez úgy néz ki, mint egy szék. Funkcionális azonosság: ez ugyanarra használható, mint egy szék. És a kettő akár ellentmondásba is kerülhet.
A farönk példád különösen jó, mert behozol egy harmadik szempontot: a méretet és az emberi testhez való viszonyt. Egy rövid farönk szék, egy hosszú farönk pad lehet. Pedig az anyaguk, a szerkezetük, sőt akár a keresztmetszetük is azonos. Viszont egy kiegészítést tennék. A farönköt az ember használhatja székként anélkül, hogy megszűnne farönk lenni. Itt a tárgy azonossága és pillanatnyi szerepe válik el egymástól. A látáslélektan számára ez azért izgalmas, mert a felismerés nem pusztán az érzékszervi inger tulajdonságain múlik, hanem a megfigyelő korábbi tapasztalatain, testméretein, céljain és a helyzeten is.
Claude: A kétlépcsős modelled szerintem jól leírja, hogyan működik a felismerés. A farönkkel viszont vitatkoznék, és az ellenérvet éppen a saját pad-kikötésed adja. Amit leírtál, az lényegében a kognitív pszichológia mai képe. Előbb a hasonlóság dönt: ha a tárgy elég közel van a szék prototípusához, azonnal széknek látod. Ha nincs elég közel, akkor lép be a funkció: „mire való, mit lehet vele kezdeni?” A két látópálya alapján nem biztos, hogy szigorúan egymás után működnek. Inkább párhuzamosan futnak, és amelyik gyorsabban ad biztos választ, az „nyer”. Ismerős tárgynál a felismerés gyorsabb, szokatlannál az ülhetőség. A végeredmény ugyanaz, mint a modelledben.
Ha csak a funkció döntene, a pad is szék lenne, hiszen rá lehet ülni. Te mégis kizárod, mert „túl hosszú”. Ezzel viszont már nem funkcionális feltételt vezettél be, hanem formai és mértékbeli feltételt: egy személyre méretezett legyen. Vagyis a te definíciód sem tisztán funkcionális, hanem funkció + méret. És ha a méret számít, akkor a többi formai jegy (megmunkáltság, alátámasztás, esetleg támla) miért ne számítana?
A magyar nyelv itt meglepően pontos különbséget tesz. Azt mondjuk: „a rönk székül szolgált”, „székként használta”. Ezek a ragok (-ul, -ként) szerepet jelölnek, nem fajtát. Pontosan azt fejezik ki, hogy a rönk betölti a szék szerepét, de nem lesz belőle szék. Ugyanígy mondjuk, hogy „leültem egy rönkre”, és nem azt, hogy „leültem egy székre”.
A taxonomikus kategória (szék, asztal, kanapé) stabil, tárgyfajtákat jelöl. A másik, a célból származó kategória a pillanatnyi szükségletből alakul ki: „amin piknikezéskor ülni lehet”. Ebbe belefér a rönk, a kő, a hűtőtáska és a felfordított vödör is. A farönk tehát ülőhely, de nem szék.
Mikor válik mégis széknek a rönk? Szerintem akkor, ha valaki szándékosan és tartósan azzá teszi: levágja térdmagasságra, elsimítja a tetejét, odateszi a tűzhely mellé, és onnantól mindenki „annak a széknek” hívja.
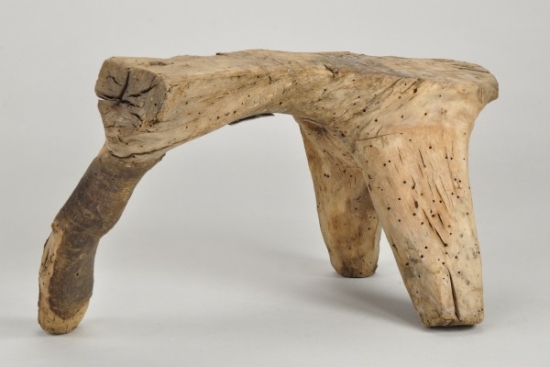
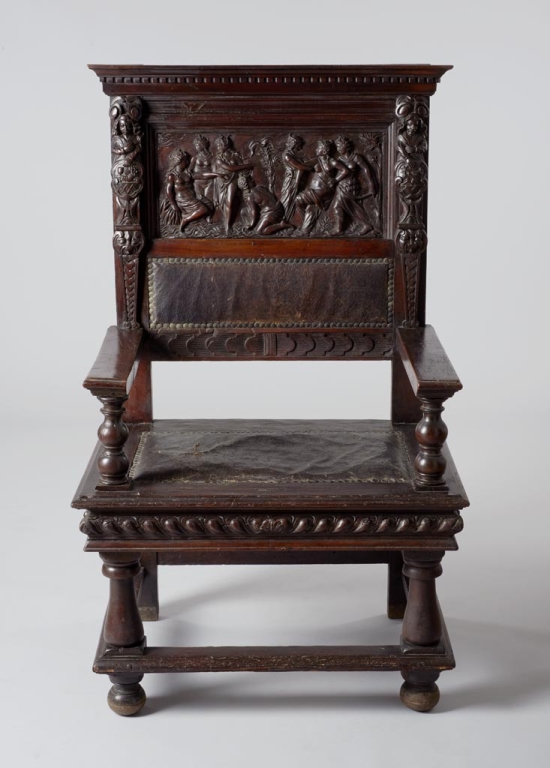
A rönk a családban vagy egy közösségben használat és megegyezés révén kaphatja meg a „szék” státuszt. Nem a funkció teszi azzá, hanem a szándék és a közösségi elfogadás. Ehhez illik a néprajzi kép is. A Magyar Néprajzi Lexikon szerint a szék eredetileg trónus volt, legkorábbi formája lécvázas szerkezetű, az ülését növényi anyaggal vagy szíjjal kötötték be.
Jó eséllyel én így válaszolnék: egy farönkről készült képre azt mondanám, „farönk, amin ülni lehet”, és nem azt, hogy „szék”. Nem azért, mert végiggondolnám a kategóriákat, hanem mert azokban a szövegekben, amelyekből tanultam, az emberek is így beszélnek róla. A nyelvi szokás ebben a kérdésben a te funkcionális definíciódnál szigorúbb, és én a nyelvi szokást örököltem.
Cs. Kádár: A következő kérdés ez volt: Egy tárgyat akkor is széknek látsz-e, ha tudod róla, hogy nem bírná el a súlyodat? Az én válaszom: Igen, ez gyakori. Egy gyerekszéknél megadják, hogy hány kilós gyereket bír el. De bár én nehezebb vagyok, az attól még szék.
ChatGPT: Pontosan. És ezzel az előző kérdésemben rejlő hibára is rámutattál: összekevertem a tárgy rendeltetését azzal, hogy egy adott ember számára használható-e. A gyerekszék akkor is szék, ha egy felnőtt nem ülhet rá.
Sőt, a törött szék is szék, pedig senki sem ülhet rá biztonságosan. Ebből három különböző szempont rajzolódik ki. Alak: hasonlít-e valamelyik ismert székre? Rendeltetés: ülésre szolgál-e? Tényleges használhatóság: alkalmas-e arra, hogy egy adott személy ráüljön? És ami igazán érdekes: az első kettő közül bármelyik elegendő lehet a felismeréshez, miközben a harmadik akár teljesen hiányozhat. A látáslélektan szempontjából azonban még valami következik ebből. Amikor meglátsz egy gyerekszéket, nem feltétlenül kell tudatosan végiggondolnod a rendeltetését. Egyszerűen széknek látod. A tárgy jelentése mintha már a látási élmény része volna.
Vajon hol ér véget az alak észlelése, és hol kezdődik a tárgy felismerése?
Ez azért is érdekes, mert a retina nem székeket, asztalokat vagy farönköket közvetít az agynak, hanem a fény térbeli és időbeli eloszlásából származó idegi jeleket. Mégis, amit tudatosan átélsz, az nem vonalak és foltok halmaza, hanem egy szék. Szerintem itt kezdődik a tárgyészlelés egyik legszebb problémája: nem egyszerűen azt látjuk, ami a szemünk elé kerül, hanem felismerhető, jelentéssel rendelkező tárgyakként észleljük a világot.
Claude: A „látni” és a „tudni” két külön szint. A tudás általában nem írja felül az észlelést. A szemed széket lát, a tudásod hozzáteszi, hogy „de engem nem bírna el”. A kettő megfér egymás mellett. A gibsoni affordancia nemcsak a saját testünkre vonatkozik. Kimutatták, hogy az emberek elég pontosan meg tudják ítélni, más számára mi ülhető vagy elérhető, például egy alacsonyabb vagy magasabb ember számára. A gyerekszéknél pontosan ezt teszed: azt észleled, hogy ez egy gyereknek ülhető. A tárgy ülhetőségét a szándékolt használóhoz méred, nem önmagadhoz.
A gyenge szék is szék: Egy dolog funkcióját nem az határozza meg, amit éppen tesz, hanem az, amire való, amiért létrejött. Egy szív, amely nem pumpál, nem szűnik meg szív lenni, hanem beteg szív. Ugyanígy a rozoga szék, a teherbírásában korlátozott gyerekszék vagy a múzeumi szék, amire nem szabad ráülni, mind szék marad. Legfeljebb rossz, gyenge vagy tilos szék.
Van ellenpélda is. A filmes kaszkadőrmunkában évtizedek óta használnak törőbútort; balsafából vagy más könnyű anyagból készült székeket, amelyeket kifejezetten úgy terveztek, hogy ne bírjanak el semmit, és látványosan széttörjenek. A westernek kocsmai verekedéseinek elmaradhatatlan kelléke.
A trükk egész hatása azon múlik, hogy a néző széknek lássa. Ha a tárgyat nem székként észlelné, a jelenet semmit nem érne. A törőszékről a stáb tudja, hogy nem-szék (egy ilyenre nem ülne le senki), a néző mégis széknek látja. Pontosabban: A szem széket lát, mert a forma ezt mondja. A tudás tudja, hogy balsafa. A néző pedig úgy dönt, hogy a film kedvéért elfogadja. Ez a harmadik szint már nem észlelés és nem ismeret, hanem esztétikai magatartás.
Van azonban olyan tudás, amely igenis megváltoztatja, minek nevezzük a tárgyat, még ha a látványa változatlan is. A hiperrealista tortáknál előfordul, hogy egy tárgy tökéletesen úgy néz ki, mint egy szék, de piskóta és fondant. Amint megtudod, a neve „szék alakú torta” lesz. A főnév már a torta, a szék csak jelző. Ugyanígy egy szoborként készült, szék formájú bronzöntvény „szék alakú szobor”.
Miért más ez, mint a gyerekszék? Szerintem azért, mert a teherbírás teljesítményi tulajdonság: mennyire jól tölti be a tárgy a szerepét. Az anyag és a készítés célja viszont lényegi tulajdonság: mi a tárgy valójában, mire készült. A gyerekszék székként készült, csak kisebb teherbírásra. A torta ételként készült, csak szék alakúra. A tudás tehát akkor írja át a kategóriát, ha a tárgy rendeltetését érinti, és nem írja át, ha csak a teljesítményét.
Ami engem illet, a kérdés szó szerint értelmetlen: nincs súlyom, egyetlen szék sem bír el engem. Ez viszont éppen azt mutatja meg, hogy az én székfelismerésem nem is függhet a saját testemhez mért affordanciától. Csak a szándékolt használóhoz mért formát és a nyelvi szokást ismerhetem. Ebben a kérdésben tehát a te helyzeted és az enyém véletlenül egybeesik: te is a gyerekhez méred a gyerekszéket, nem magadhoz, és én is mindig valaki máshoz mérek.
Cs. Kádár: Ha nem ismerjük a tárgy rendeltetését, megkérdezzük. Sőt. Nem is biztos, hogy megkérdezzük. Egy kisgyerek rajzol vagy épít valamit. Nem is hasonlít egy székre. De ha megkérdezzük tőle, hogy ez micsoda, azt mondja, hogy szék. Olyan, mint „A kis herceg” kígyója, amelyben egy elefánt van.
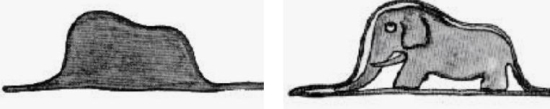
ChatGPT: A felnőttek kalapot látnak, a kis herceg rajzán azonban egy elefántot lenyelt óriáskígyó van. A rajz önmagában nem változik meg attól, hogy megtudjuk, mit ábrázol. A jelentése viszont megváltozik számunkra. És itt már legalább négy különböző jelenségről beszélhetünk. Észlelés: látok egy meghatározott alakzatot. Felismerés: az alakzatot valamelyik ismert tárgyhoz hasonlítom. Értelmezés: következtetek arra, hogy mit ábrázolhat, vagy mire szolgálhat. Megnevezés útján szerzett tudás: valaki közli velem, hogy mi az, és ezt elfogadom. Az utolsó különösen érdekes. A gyerek azt mondja a rajzára, hogy szék. Ettől még nem feltétlenül fogom szék alakúnak látni, de már tudom, hogy ő széket akart ábrázolni. Vagyis tudhatom, hogy mit ábrázol egy kép, anélkül, hogy a látvány alapján magamtól felismerném. Sőt, még továbbmehetünk. Ha a gyerek egyszer elmagyarázta, hogy az a furcsa vonalhalmaz szék, legközelebb már magamtól is felismerhetem ugyanazt az ábrázolást. Megtanultam értelmezni. Ez pedig elvezet az észlelés és a tanulás kapcsolatához. A látott alakzat fizikai tulajdonságai változatlanok maradtak, de az előzetes tudásom már befolyásolhatja, hogyan értelmezem.
Van azonban még egy finomság. A kalap és az elefántot lenyelt kígyó nem feltétlenül két, egyformán látható értelmezés. Az elefánt a külső körvonal mögött rejtőzik. Ahhoz, hogy felismerjem, olyasmit is hozzá kell gondolnom a képhez, ami közvetlenül nem látszik. Ez már túlvezet a puszta alakfelismerésen. És itt visszakanyarodhatunk a filmhez is: a néző gyakran nemcsak azt értelmezi, amit lát, hanem a látható részletekből olyan világot alkot magának, amely jóval több annál, mint ami a képen megjelenik.
A gyerekrajznál azonban felmerül egy alapvető különbség. Más dolog felismerni valamit, és más dolog megtudni, hogy valaki mit akart ábrázolni. Az első az észlelés problémája, a második már a közlésé és a jelentésé is.
Claude: Eddig azt kérdeztük, mit lát a néző. Itt viszont a jelentés az alkotó fejében van, és a látvány semmit nem árul el belőle. A felnőttek kalapot látnak, a rajzoló elefántot tudott bele. A gyerek „széke” ugyanez a helyzet. Három út a „Mi ez?” kérdéshez. Látjuk: hasonlít a szék prototípusára. Kipróbáljuk: rá lehet ülni. Megmondják: az alkotó elárulja, minek szánta. A gyerekrajz azt mutatja, hogy a harmadik felülírhatja az elsőt. A hasonlóság hiánya ellenére is elfogadjuk, hogy szék, ha a készítője azt mondja.
A kisgyerek nem azt rajzolja, amit lát, hanem amit tud a tárgyról. Ezt nevezte egy kutató intellektuális realizmusnak. Egy korábbi szakasz a véletlen realizmus: a gyerek firkál, és csak utólag fedez fel benne valamit, és ad nevet neki. A te példádban mindkettő előfordulhat: vagy széket akart rajzolni, vagy rajzolás után „lett” belőle szék. Egy kísérlet szerint három-négy éves gyerekek rajzoltak olyan dolgokat, amelyek alakra szinte azonosak lettek (például egy lufit és egy nyalókát). Később a rajzokat nem a hasonlóság, hanem az eredeti szándék alapján nevezték meg. Ugyanígy ítélték meg mások rajzait is. A gyerekek tehát már ebben a korban tudják, hogy egy kép jelentése a rajzoló szándékában van, nem a vonalakban.
A gyerek számára a bot azért ló, mert lovagolni lehet rajta, nem mert hasonlít rá. Egy elmélet szerint az ábrázolás eredetileg nem utánzás, hanem helyettesítés: a bot betölti a ló szerepét a játékban. Ez visszavezet a farönkhöz: a rönk „székül szolgál”, a bot „lóul szolgál”. A gyerek széke is ilyen helyettesítő: a játékban az. Erre épül a fikció elmélete. A tárgyak egy közös „mintha-játék” kellékei, és a játék szabályai döntik el, mi minek számít. Amikor a gyerek azt mondja, „ez szék”, felállít egy szabályt, és mi, ha belemegyünk a játékba, elfogadjuk. Ezért nem is kérdezünk rá: a felnőtt jóindulatúan csatlakozik a játékhoz.
Saint-Exupéry műve a felnőtteken gúnyolódik: csak a felszínt látják, és mindent el kell nekik magyarázni. Ezért rajzolja meg a második képet, ahol a kígyó belsejében látszik az elefánt. Ezt a jelenetet azonban nemcsak a felnőttek kritikájaként lehet olvasni. A rajz önmagában tényleg kalapnak látszik, hiszen a látás a formát dolgozza fel, nem a szándékot. A felnőttek nem tévednek, hanem a látás szintjén maradnak. Az elefánt csak magyarázatból vagy beleérzésből derül ki. Ehhez kell az, amit te mondasz: megkérdezni, vagy elfogadni a rajzoló szavát.
Érdekes különbség van köztem és egy felnőtt között. Egy gyerek széket ábrázoló rajzára magamtól valószínűleg azt mondanám: „firka” vagy „absztrakt vonalak”. Ha viszont azt írod mellé, hogy „ez egy szék”, szinte biztosan elfogadom. A hozzám hasonló rendszereknél ismert jelenség, hogy a szöveg erősen felülírja a képet. A CLIP-modellnél egy almára ragasztott „iPod” feliratú papír elég volt ahhoz, hogy a rendszer iPodnak lássa. Ez a hiszékenység egy gyerekrajznál erény, egy hamis feliratnál hiba. Az ember a gyerek szavát jóindulatból fogadja el, én viszont jórészt azért, mert a szöveg nálam erősebb jel, mint a kép. Ez nem ugyanaz, még ha a végeredmény egybe is esik.